可重跑教學 · 時間序列預測與模型評估
TimesFM × UCI Online Retail:用真實銷售資料學會公平比較預測模型
回學習中心首頁 · 回研究索引 · TimesFM 原始碼
模型效果:誰贏、差多少、錯在哪裡?
Seasonal Naive(7)
MAE £15,184.71/日
WAPE 27.12%;MAE、RMSE、sMAPE、WAPE 四項都最低。先保留為正式基線。
TimesFM 3.0
MAE £15,833.95/日
比冠軍多 £649.24/日(+4.28%);WAPE 28.28%,高 1.16 個百分點。
ETS
MAE £17,457.94/日
比冠軍多 £2,273.23/日(+14.97%);WAPE 31.18%,但 RMSE、sMAPE 略優於 TimesFM。
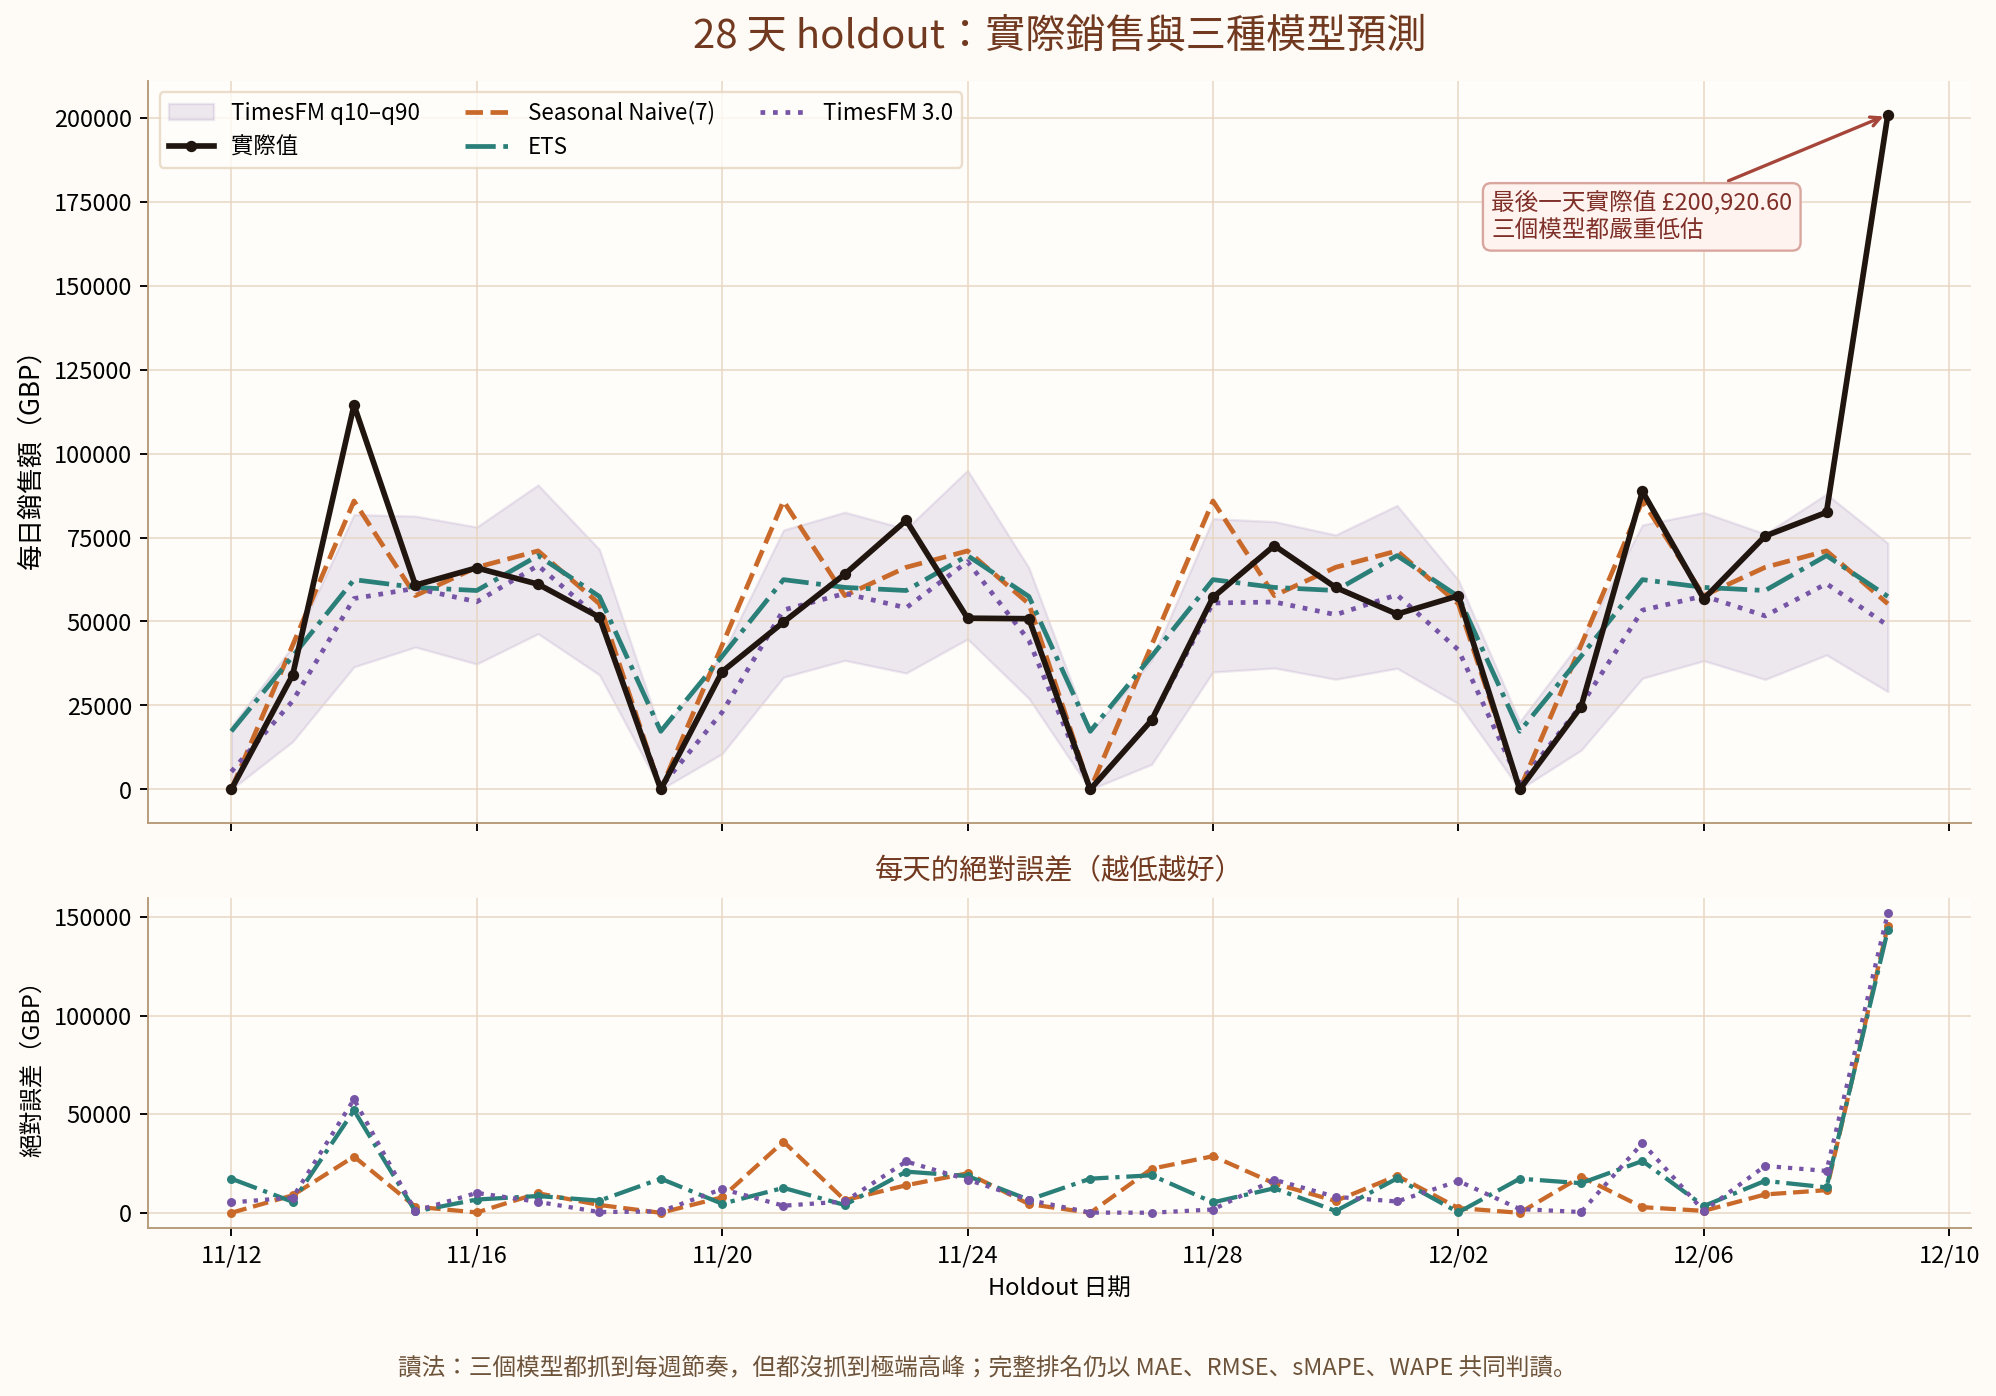
把模型效果翻成人話
- TimesFM 不是冠軍:按 MAE 與 WAPE 它排第二;但 RMSE 為 £33,164.46(ETS 為 £31,568.15),sMAPE 為 49.56%(ETS 為 49.47%),反而略輸 ETS。四項都輸 Seasonal Naive(7),所以唯一穩定結論是 Seasonal Naive 勝出,不能宣稱 TimesFM 全面第二。
- 真正的共同弱點是尖峰。2011-12-09 實際值為 £200,920.60;Seasonal Naive 預測 £55,257.17、ETS 預測 £57,441.06、TimesFM 預測 £48,782.46。TimesFM 當天低估 £152,138.14(75.72%)。
- 拿掉最後一天做敏感度檢查,排名仍沒變。前 27 天 MAE 依序是 Seasonal Naive £10,352.17、TimesFM £10,785.65、ETS £12,790.47。最後尖峰放大整體誤差,但不是 Seasonal Naive 勝出的唯一原因;這項檢查只用來理解誤差,不拿來重新挑 holdout。
- TimesFM 的區間有參考價值,但還不能說已校準。q10–q90 名義 80% 區間涵蓋 24/28 天(85.71%),平均寬度 £38,005.06;樣本只有 28 點,而且最後尖峰仍落在區間外。
- 目前決策:保留 Seasonal Naive(7) 當 champion,TimesFM 只當 challenger。等 rolling-origin 在多個月份與 horizon 重複勝出,再談替換基線。
不要把 WAPE 倒過來叫「準確率」:WAPE 27.12% 的意思是,這 28 天的絕對誤差總和約為實際銷售總量的 27.12%;不能直接宣稱模型「準確率 72.88%」。完整四項指標與限制見下方結果表。
metrics.json、metadata.json 與輸出 CSV;新增的 27 天敏感度檢查由同一份 forecast_holdout.csv 重算。本文沒有匯入任何正式 GA4、CRM、廣告帳戶資料,也沒有把這個公開案例包裝成 production benchmark 或 uplift 實驗。第一個問題:預測到底能回答什麼?
想像你在週五下午問:「根據目前已知的銷售歷史,下週每天大概會有多少英鎊的正向商品銷售?」這是 forecast。模型可以利用趨勢、週期、假日訊號與在預測時已經看得到的欄位,估計未來的數值。
但如果問題改成:「這次把廣告預算增加後,多賣出的銷售額是多少?」那是 causal uplift。它需要 treatment、對照或其他能識別反事實的設計;只看銷售曲線上升,無法排除節慶、價格、供貨、自然流量或其他同時發生的變化。
Forecast
估計在目前資訊與既有模式下,未來會觀察到什麼。可以用來排班、備貨與預算規劃。
相關
兩條曲線一起變動。它是描述性的訊號,不自動代表其中一條造成另一條。
因果 uplift
比較「有介入」和「沒有介入」的反事實差異。需要實驗、準實驗或清楚的識別假設。
本頁不做的事:不把 TimesFM 的點預測寫成廣告增量、ROAS、客戶終身價值或任何投放因果效果。這個案例只能回答「若歷史模式延續,基準銷售可能如何走」。
問題定義:用日銷售毛額預測接下來 28 天
我們把原始公開交易資料聚合成日序列,target 命名為 gross_sales_gbp,單位是每天英鎊。只保留商品數量與單價都為正的列,先計算每列的商品價值,再按日期加總:
因此這裡的 target 是「正向商品銷售毛額」,不是扣除退貨後的淨收入,也不是完整 demand,更不是廣告增量。非正向列會被排除,排除筆數仍寫入本次 provenance 統計,讓資料選擇可以被稽核。
UCI 將 Online Retail 描述為英國非店面零售的交易型時間序列資料;公開資料期間是 2010-12-01 到 2011-12-09,共 541,909 筆資料,頁面另列出變數表與資料說明。[4] 本頁不展示原始識別碼或客戶層級欄位,只展示聚合後的教學 target。
資料來源與安全資料字典
資料來自 UCI Machine Learning Repository 的 Online Retail,下載檔是 UCI 公開的 zip archive。[4][9]
UCI 頁面列出的授權是 Creative Commons Attribution 4.0 International;重用資料時應保留適當 attribution。[4][5]
| 處理後欄位 | 單位/定義 | 本頁用途 |
|---|---|---|
date | 日曆日期;把交易時間正規化到日粒度。 | 時間索引與 chronological split。 |
gross_sales_gbp | 符合正向銷售條件的商品價值日總和,英鎊/日。 | 本次唯一 forecast target。 |
sold_units | 符合條件的商品數量日總和。 | 保留在 processed CSV 作為可稽核的輔助聚合。 |
invoice_count | 正向銷售列所對應的交易數量聚合。 | 只作資料檢查,不進本次模型。 |
source_row_count | 當天符合條件的來源列數。 | 檢查聚合後日序列與原始資料量是否合理。 |
完整日曆會把「沒有正向銷售列」的日期補成 0。這不是插值,也不是捏造交易,而是明確定義「當天沒有觀測到正向銷售」的資料契約。公開頁面不放原始檔、客戶層級資料或大型 checkpoint。
為什麼不能 random split?
時間序列的預測問題有一個不可逆的方向:預測日發生在訓練資料之後。若把日期隨機打散,模型可能在訓練階段看到「未來月份的模式」,評估時再假裝那些資訊不存在,結果會比真正上線時樂觀。
2010-12-01 至 2011-11-11
346 個每日觀測。所有模型 fit 或建立 context 只使用這段。
2011-11-11 之後
把預測起點固定下來,先決定切分與流程,再看 holdout 答案。
2011-11-12 至 2011-12-09
28 天、horizon = 28。只用於最後計算誤差,不回填 context。
時間正確性:所有 fit、normalization、特徵規則與模型選擇,都必須在 holdout_start 之前決定;holdout 的實際值只在評估階段出現。
這個案例的切分是單一 chronological holdout,不是 rolling-origin 全面評估。因此它能告訴我們三個模型在這一個指定窗口的表現,不能保證下一個月份、另一個市場或生產資料也會保持同樣排序。
Leakage 清單:尤其小心 lag 與 rolling
在 forecast origin 當下,特徵只能由當時看得到的資料組成。最容易出錯的地方不是模型 API,而是特徵工程悄悄把答案放進去。
- 先切時間,再 fit、標準化、選超參數;不要先對全資料算統計量。
- Seasonal Naive 只重複 train 尾端的 7 天;ETS 只用 train fit;TimesFM 只接收 train target。
- lag 只使用過去值;未來日期若沒有已核准的資料,不能把事後實績當作 future-known。
- rolling 特徵一定先
shift(1),再 rolling;否則當日的 target 會參與當日特徵。 - 不要用 holdout 指標挑完模型後,再回頭調整 holdout 日期或指標。
- 每個 rolling origin 都要重做「當時可見」的 join、特徵與預測,不可把後來補回的資料倒灌。
# 這段只讀取處理後的日序列,不含客戶層級原始欄位。
import pandas as pd

daily = pd.read_csv("data/processed/daily_gross_sales.csv", parse_dates=["date"])
daily = daily.sort_values("date").reset_index(drop=True)
y = daily["gross_sales_gbp"].astype("float64")

# 輸入:截至目前的 y;輸出:只由更早日期形成的 lag 與 rolling 特徵。
features = pd.DataFrame({"date": daily["date"], "target": y})
features["lag_7"] = y.shift(7)
features["lag_28"] = y.shift(28)
# 先 shift(1) 再 rolling,避免把當日答案放入當日平均。
features["rolling_mean_7"] = y.shift(1).rolling(7, min_periods=7).mean()
features["rolling_std_7"] = y.shift(1).rolling(7, min_periods=7).std()

# 常見錯誤:y.rolling(7).mean() 會包含當天 y;
# 若這些特徵要拿去預測當天,必須先 shift(1)。
print(features.tail())這段程式的邊界:它是可直接執行的 leakage 示範,不是本次三模型正式 pipeline 的替代品。真正做 train/holdout 時,仍須先截出 train,並在每個預測 origin 只使用該 origin 以前的列。
三種模型:從最簡單的基線開始
| 模型 | 它在假設什麼 | 本案例的實作 | 公平比較的理由 |
|---|---|---|---|
| Seasonal Naive(7) | 每週同一天的近期模式,是「下週像上週」的直接版本。 | 把 train 最後 7 個值週期性重複到 28 天。 | 低複雜度、可解釋、常是零售日資料不可跳過的基線。 |
| ETS | 用指數平滑處理水準、趨勢與週期;不使用未來外生變數。 | statsmodels additive trend、damped trend、additive weekly seasonality,period = 7。 | 代表傳統統計模型,不讓 foundation model 只和一個稻草人比。 |
| TimesFM 3.0 | 預訓練時間序列 foundation model;在這個流程中以 train context 做 zero-shot forecast。 | TimesFM3Forecaster、CPU、checkpoint `google/timesfm-3.0-pytorch`,horizon = 28。 | 代表不針對這個資料集重新訓練的 foundation-model 路徑。[1][3][6] |
TimesFM 的初始論文描述的是 decoder-only、patched-decoder style 的時間序列 foundation model,目標是讓模型在不同 history length、prediction length 與時間粒度下進行零樣本預測。[3] 這個論文定位不等同於「在 UCI Online Retail 上必然勝過所有基線」;本頁把論文背景和本地實跑結果分開。
授權不能省略:TimesFM repository 的 source code 採 Apache-2.0。[1][2]
官方 README 明確區分 3.0 pretrained weights;現行 3.0 weights 使用另外的 `timesfm-non-commercial-license-v1.0`,限制 non-commercial、non-production use。[1][6][7]
因此本頁的 3.0 下載與結果只定位為研究、教學與內部 benchmark,不是可直接商用的部署指示。
評估指標:白話與正式定義都要看
令實際值為 y_t,預測值為 ŷ_t,holdout 有 n 個日期。每個指標看的是不同錯誤形狀,不應只挑一個對自己有利的數字。
| 指標 | 白話 | 正式定義 | 閱讀提醒 |
|---|---|---|---|
| MAE | 平均每天錯多少英鎊。 | (1/n) Σ |y_t − ŷ_t| | 單位和 target 相同,容易向業務解釋。 |
| RMSE | 大錯會被更重地懲罰。 | sqrt((1/n) Σ (y_t − ŷ_t)²) | 適合注意節慶尖峰或極端日,但容易被少數大誤差主導。 |
| sMAPE | 把誤差相對於實際值和預測值的大小來看。 | (100/n) Σ 2|y_t − ŷ_t| / (|y_t| + |ŷ_t|) | 接近 0 的日期會放大解讀難度;分母為 0 時需明確處理。 |
| WAPE | 整個窗口的絕對錯誤,占實際銷售總量的比例。 | 100 Σ|y_t − ŷ_t| / Σ|y_t| | 適合用總量觀點溝通,但仍不是因果增量。 |
本實作對 sMAPE 的零分母項採 0,對 WAPE 的實際值總和為 0 也採 0,並把定義寫在程式中。讀者若換資料,應先確認自己的零值處理與業務解釋一致,不要直接比較不同實作的百分比。
完整指標與不確定性
下表是既有 artifact 在 Linux ARM64、Python 3.13.5、CPU 上產生的結果。這是「本案例單一 28 天 holdout」,不是多次 rolling-origin,也不是作者在其他資料集上的 benchmark。
| 模型 | MAE(GBP) | RMSE(GBP) | sMAPE | WAPE |
|---|---|---|---|---|
| Seasonal Naive(7) | 15,184.71 | 30,914.67 | 21.51% | 27.12% |
| ETS | 17,457.94 | 31,568.15 | 49.47% | 31.18% |
| TimesFM 3.0 CPU | 15,833.95 | 33,164.46 | 49.56% | 28.28% |
怎麼讀:如果只在這一個 holdout 做暫時性的排序,Seasonal Naive 的四個點預測指標都優於本次 ETS 與 TimesFM 3.0,因此它應先保留為 champion baseline。這不是「Seasonal Naive 永遠最好」,也不是 TimesFM 沒有價值;它只表示在這個 target、這個資料量、這個切分與這 28 天窗口,最簡單的週期假設已經很有競爭力。
TimesFM 3.0 也實際回傳 quantile。q10 到 q90 的名義 80% prediction interval 在這 28 點的 coverage 是 0.8571,平均區間寬度是 38,005.06 GBP。28 個點不足以宣稱校準完成;coverage 高於 0.8 也不代表未來每個窗口都會如此。
如何解讀「TimesFM 沒有贏」?
模型比較的價值不只在找冠軍,也在找出目前問題的形狀。這次結果不能推導出 TimesFM 在所有零售資料、所有 horizon 或所有頻率都比較差;比較合理的判讀是:
週期基線很強
資料是日粒度,且每週購買模式可能已包含大量可預測訊號;Seasonal Naive 直接重複最近一週,沒有額外估計誤差。
target 不是完整 demand
本頁只算正向商品價值,排除非正向列;退貨、取消、供貨與促銷的影響不在同一個 target 裡。
零值與節慶
69 個零銷售日與年底窗口讓相對百分比指標、尖峰誤差與週期延伸都變得敏感。
資料量與驗證窗口有限
約一年資料、單一序列、單一 28 天 holdout;要判斷泛化,必須增加 origins 與不同 horizon。
ETS 的 sMAPE 特別高,不應直接翻譯成「模型完全不能用」;先檢查零值附近的相對誤差、加法季節模型是否適合尖峰,以及是否需要更完整的外生變數。相同地,TimesFM 的 RMSE 高於 Seasonal Naive,代表本窗口的大誤差較大,不代表它的 prediction interval 或其他資料集表現都無用。
Quantile 與 prediction interval:範圍不是保證
點預測只給一條線;quantile forecast 則給出不同位置的條件分布摘要。這次以 q10 和 q90 形成名義 80% 區間,概念上是「在類似條件下,未來值可能落在這個範圍」,而不是「每次都會有 80% 機率正確」。
coverage = holdout 中 q10(t) ≤ actual(t) ≤ q90(t) 的比例
- coverage 要在多個 rolling origins、不同 horizon 與節慶切點上檢查,不能用 28 個點單獨宣布已校準。
- 區間寬度也要一起看:很寬的區間容易提高 coverage,卻可能無法支援決策。
- 如果成本不對稱,例如缺貨比備貨過多更昂貴,應另外設計 decision threshold,而不是只看 q50。
- 讀取模型輸出時要確認 quantile index;本次 artifact 以 9 個 quantile 的第 0、4、8 欄對應 q10、q50、q90,並在程式中排序後再寫 CSV。
程式碼與重跑方式
想逐格閱讀可直接下載繁體中文 Jupyter Notebook;要實際執行請下載完整教學程式包(tar.gz)並從解壓後的根目錄啟動 Jupyter。Notebook 預設重跑 Seasonal Naive、ETS、指標與效果圖,再明確標示讀取既有 TimesFM 輸出的證據邊界,不會自動下載大型權重。
命令列入口仍是完整程式包中的 `scripts/download_data.py`、`scripts/smoke_test.py` 與 `scripts/run_forecast.py`。程式包不攜帶原始交易檔與 TimesFM checkpoint;選擇完整重跑時,才會由公開 UCI URL 與 Hugging Face checkpoint 重新取得。
程式包內容:README、Jupyter Notebook、`scripts/`、`tests/`、requirements 與已產生的示例輸出。`requirements-baseline.txt` 可先不下載模型權重跑 CPU baseline;`outputs/` 是本次已驗證示例,不是重新執行的保證。
1. 建立隔離環境與安裝 baseline
# 輸入:Python 3.10 以上;輸出:專案自己的 .venv。
# PEP 668 主機不要把 --break-system-packages 寫進教學命令。
python3 -m venv --system-site-packages .venv

# 輸入:requirements-baseline.txt;輸出:資料處理、ETS、metrics 與繪圖依賴。
.venv/bin/python -m pip install -r requirements-baseline.txt為什麼這樣寫:baseline 可以在沒有 PyTorch、沒有模型 cache 或不能下載 checkpoint 的機器上先跑完。常見錯誤是直接對系統 Python 安裝,或把 TimesFM 權重下載失敗誤寫成預測成功。
2. 下載公開資料並留下 provenance
# 輸入:UCI 公開 zip;輸出:data/raw/online_retail.zip、
# data/raw/Online Retail.xlsx、data/raw/metadata.json。
.venv/bin/python scripts/download_data.py --force

# 程式會重新計算 archive 與 XLSX 的 SHA-256;下載失敗就 exit non-zero,
# 不會用舊檔或合成資料冒充這次下載成功。
下載程式只呼叫公開 UCI URL,不接受帳號、cookie、token 或 API key。UCI dataset page 與下載檔是本教學的資料來源。[4][9]
3. 先跑單元測試與 baseline smoke test
# 輸入:已下載的 raw data 與 metadata;輸出:測試結果與 smoke 目錄。
.venv/bin/python -m unittest discover -s tests -v
.venv/bin/python scripts/smoke_test.py

# smoke_test 會使用 --horizon 7、--holdout 7、--timesfm off,
# 確認 metrics.json、forecast_holdout.csv 與 forecast_comparison.png 都存在。
# 它明確要求 TimesFM status 為 skipped,避免把 baseline smoke 誤當完整模型實跑。
既有驗證紀錄是 3 個 tests、結果 `OK`;smoke test exit 0,且三個輸出檔非空。這些是 artifact 的已驗證紀錄,不是本文重新捏造的測試結果。若你的程式目錄沒有 `tests/`,不要把空目錄當成測試通過;先取得完整教學程式包,再執行上面的 unittest 命令。
4. 安裝並執行 TimesFM 3.0
# 輸入:baseline 依賴與支援主機架構的 PyTorch;輸出:TimesFM 套件。
.venv/bin/python -m pip install -r requirements-timesfm.txt

# 輸入:只到 holdout_start 以前的 target;輸出:28 天 forecast、quantiles、metrics、CSV 與 PNG。
.venv/bin/python scripts/run_forecast.py \
  --horizon 28 \
  --holdout 28 \
  --timesfm auto

# 若你要求 TimesFM 必須成功,改用 required;下載或載入失敗時應該 exit non-zero。
.venv/bin/python scripts/run_forecast.py \
  --horizon 28 \
  --holdout 28 \
--timesfm required三個模式:auto 會保留 CPU baseline,並把 TimesFM 失敗類型寫入 `metrics.json`;off 明確跳過 checkpoint;required 把 TimesFM 載入失敗升成錯誤。這個 fallback 是為了讓失敗可見,不是用 baseline 數字冒充 TimesFM。
5. 核心 TimesFM 呼叫(可直接執行的最小片段)
# 輸入:processed daily CSV;輸出:point forecast 與 quantile forecast。
import numpy as np
import pandas as pd
from timesfm3 import TimesFM3Forecaster

daily = pd.read_csv("data/processed/daily_gross_sales.csv", parse_dates=["date"])
daily = daily.sort_values("date").reset_index(drop=True)

# 先切出最後 28 天做 holdout;模型 context 只看更早的 target。
horizon = 28
train_values = daily.iloc[:-horizon]["gross_sales_gbp"].to_numpy(dtype="float32")

# checkpoint 由 Hugging Face 在本機 cache;不要把權重複製進教學 artifact。
forecaster = TimesFM3Forecaster.from_pretrained(
    "google/timesfm-3.0-pytorch",
    device="cpu",
    per_core_batch_size=1,
)
output = forecaster.predict(
    train_values,
    horizon=horizon,
    return_quantiles=True,
    make_positive=True,
    sort_quantiles=True,
    use_znorm=False,
    padding_mode="none",
)
point = np.asarray(output.forecast, dtype=float).reshape(-1)[:horizon]
quantiles = np.asarray(output.quantiles, dtype=float)[:horizon]
q10, q50, q90 = quantiles[:, 0], quantiles[:, 4], quantiles[:, 8]
print(point.shape, q10.shape, q50.shape, q90.shape)

# 常見錯誤:把 holdout actual 傳進 context、誤讀 quantile index,
# 或把 checkpoint 下載失敗後的 NaN 當成模型預測;正式腳本會檢查 shape 與 finite values。
官方 README 目前提供 TimesFM 3.0 checkpoint、multivariate 與 past-only/past-and-future covariate 的說明;官方 model card 則列出 checkpoint 的模型資訊與 license。[1][6][8] 上面的最小片段說明核心 API,完整 artifact 另外負責 target 聚合、時間切分、ETS、metrics、CSV、圖與 fallback。
GA4、CRM 與廣告欄位:先分清 future-known 和 past-only
本次實跑刻意只用交易 target,沒有匯入正式 GA4、CRM 或廣告資料。下面是隔離資料環境中設計欄位契約的方法示意,不是已完成的正式資料映射,也不代表這些欄位一定提升準確度。
| 來源 | 可以考慮的日粒度欄位 | 預測時可否使用 | 常見泄漏 |
|---|---|---|---|
| GA4 | sessions、engaged sessions、conversions、channel、campaign key。 | 已在 origin 前結算的歷史值可作 past-only;未來已排程的活動日曆可作 future-known。 | 把 holdout 期間事後完成或回補的 sessions、conversions 當成未來輸入。 |
| CRM | 日聚合的 lead count、opportunity count、匿名 segment count。 | 只用已授權、已聚合且在 origin 前可見的資料。 | 把事後更新的 stage 或個人層級資料 join 到 forecast input。 |
| 廣告 | 已核准 planned spend、planned impression、活動日曆;actual spend、clicks。 | planned 欄位若在預測前已確定,可是 future-known;actual metrics 多半是 past-only。 | 把未來 actual clicks、actual spend 或歸因結果當成已知答案的一部分。 |
建議每一列都保留 observed_at、forecast_origin、is_future_known 與來源版本。若 observed_at > forecast_origin,實際結果只能留在 label 或監控,不能進該次 forecast input。正式資料仍須在授權、隔離、匿名化與存取控管下處理;不要把任何秘密或 customer-level data 放進公開教學。
下一層比較:ARIMA、SARIMAX 與 lag-feature 機器學習
公平比較不是「只放一個 baseline,再和 TimesFM 二選一」。如果問題需要更明確的參數解釋或外生變數,還可以增加下列候選;本頁只提出評估設計,沒有把它們冒充成已完成的本次實跑。
| 候選 | 適合問的問題 | 需要小心的地方 | 目前狀態 |
|---|---|---|---|
| ARIMA | 差分後的自相關與趨勢,是否足以解釋單一序列? | 階數選擇、差分、零值、季節性與殘差檢查都必須在 train 內完成。 | 延伸候選,尚未在本案例執行。 |
| SARIMAX | 季節 ARIMA 加上已知的外生變數,是否能解釋節慶或已排程活動? | 未來 exogenous 欄位必須真的在整段 horizon 已知;缺一段就不能假裝有。 | 延伸候選,尚未在本案例執行。 |
| LightGBM/XGBoost | lag、rolling、日曆與活動欄位的非線性組合是否有額外訊號? | 沒有自然的時間順序;需手動建立 lag,使用 time split,避免 random K-fold 和 rolling leakage。 | 延伸候選,尚未在本案例執行。 |
# 這是 lag-feature 模型的資料契約示意;先建特徵,再按日期切分。
# 輸入:processed daily CSV;輸出:可供 LightGBM/XGBoost 使用的歷史特徵表。
features = features.dropna(subset=["lag_7", "lag_28", "rolling_mean_7"])
train_features = features[features["date"] < "2011-11-12"].copy()
holdout_features = features[features["date"] >= "2011-11-12"].copy()

# 不要把 holdout 的 target 反向填回 holdout_features;
# rolling-origin 評估時,要在每個 origin 重建到當時為止的特徵。
print(train_features.shape, holdout_features.shape)
比較時要把「模型類別差異」和「特徵資訊量差異」分開說。若 SARIMAX 看得到已排程活動,而 Seasonal Naive 看不到,結果反映的是資訊集合不同,不只是演算法優劣。
不要被一次 holdout 說服:rolling-origin 設計
本案例的單一 28 天 holdout 適合教學與端到端 smoke,但不夠支撐長期選模。下一步應保留最後一段真正 untouched 的 final test,並在更早的資料上做 3–5 個 rolling origins。
| 設計項目 | 建議 | 為什麼 |
|---|---|---|
| origins | 選 3–5 個依時間遞增的預測起點;每個 origin 只用之前資料。 | 檢查模型排序是否只在某一個月份成立。 |
| horizon | 至少比較 7、14、28 天;若業務還有月度規劃,再加更長 horizon。 | 短期週期和長期節慶效果可能由不同模型捕捉。 |
| 節慶切點 | 特別保留年底或促銷活動前後的 origin,並事前定義如何標註。 | 避免平均指標把尖峰需求沖淡。 |
| 模型選擇 | 只用 rolling validation 選 champion;最後 final test 只報一次。 | 避免反覆看 final test 後過度調參。 |
| interval | 同時報 coverage、平均寬度與極端日的失敗案例。 | 區間不能只追求寬或只追求命中率。 |
歷史驗證
每個起點重建 context、lag、rolling 與可用 covariates。
選模型與權重
只根據 rolling 指標、成本函數與區間品質選 champion 或 ensemble。
一次揭露
固定流程後才看最後窗口;不因一次結果回頭改規則。
若多個模型在不同 origin 各有優勢,可以做 ensemble,例如在 rolling validation 估計固定權重,再把 Seasonal Naive、ETS、TimesFM 的 forecast 加權平均。權重不能直接用最後 holdout 的答案調出來;而且 ensemble 也要和最強單一基線一起比較,避免「平均」只是增加複雜度。
下一步:從教學 artifact 走向可稽核評估
- 先保留 Seasonal Naive 作為 champion baseline,補上 3–5 個 rolling origins、7/14/28 horizon 與節慶切點。
- 用同一套 time split 加入 ARIMA/SARIMAX 與 lag-feature LightGBM/XGBoost;記錄每個模型看到的資訊集合。
- 把 prediction interval 的 coverage、寬度、尖峰日錯誤與業務成本一起評估,不只追 MAE。
- 若要加入 GA4、CRM 或廣告欄位,先建立 observed_at、origin、future-known 的 join audit,再於隔離且授權的資料管線執行。
- 若目標真的變成「廣告帶來多少增量」,另立 treatment/control 或準實驗設計;不要把 forecast 結果直接送進 uplift 結論。
- 如果考慮 TimesFM 3.0 production 使用,先重新確認 weights license、商業授權與供應鏈,不把本教學的 non-commercial checkpoint 當作部署許可。
證據界線與限制
- 本案例只使用公開 UCI Online Retail;未使用正式 GA4、CRM 或廣告資料。
- 本案例只有單一 28 天 holdout;尚未完成 3–5 個 rolling-origin 的全面評估。
- q10–q90 coverage 0.8571 只來自 28 個點,不能宣稱 prediction interval 已校準。
- TimesFM 3.0 weights 目前是 non-commercial、non-production 授權;不可直接商用。
- 本頁不是 uplift 實驗;任何廣告增量、ROAS 或因果效果都需要另外的識別設計。
- UCI archive、TimesFM README 與 model card 都可能更新;若重跑,應重新驗證來源、checksum、套件版本與 metrics。
最重要的閱讀習慣:先問「這個數字是誰的證據?」再問「哪個模型比較新?」公開來源、本地實跑 artifact、工程推論與尚未執行的延伸建議,必須分開標示。
來源
正文的 [1]–[9] 由本次 citation ledger 登錄;外部來源支撐 TimesFM、UCI 資料、論文與授權敘述。模型比較表、checksum、metrics 與測試狀態若標示「本地實跑」,則以既有 artifact 為準,不把外部官方 benchmark 改寫成本案例結果。
- TimesFM 官方 README:模型定位、3.0 checkpoint、covariate 說明與 weights license notice。
- TimesFM 官方 pyproject.toml:目前套件版本與 source package 的 Apache-2.0 宣告。
- TimesFM 初始論文:A decoder-only foundation model for time-series forecasting:模型研究背景、patched-decoder 與零樣本預測脈絡。
- UCI Online Retail dataset page:資料期間、資料集規模、資料集說明、引用與授權連結。
- Creative Commons Attribution 4.0 legal code:CC BY 4.0 的授權條款與 attribution 要求。
- Hugging Face:google/timesfm-3.0-pytorch:官方 PyTorch weights、model details、quantile 與 license 標示。
- TimesFM Non-Commercial License v1.0:3.0 checkpoint 的 non-commercial/non-production 使用限制。
- TimesFM forecasting skill(官方 repository):forecasting、quantile index、covariate 與常見實作錯誤的補充說明。
- UCI Online Retail 公開下載檔:本次 metadata 所記錄的 archive URL。
來源頁面會更新;若讀者要重現本案例,請以當次下載的 metadata、套件版本、checkpoint repo 與輸出 metrics 一起保存。本文沒有把大型原始資料或模型權重放進網站 artifact。